KI-Agenten automatisieren zunehmend komplexe Entwicklungsschritte. Doch ihr Nutzen hängt von Systemkontext, Prüfverfahren und klaren Verantwortlichkeiten ab, erklärt Christoph Stockhammer, Principal Application Engineer bei Mathworks, im Interview.
KI-Agenten können Code generieren, Tests ausführen und Entwicklungsprozesse beschleunigen. Doch wer stellt sicher, dass die Ergebnisse auch fachlich korrekt sind? Mathworks-Experte Christoph Stockhammer erläutert, warum menschliche Kontrolle und unabhängige Verifikation unverzichtbar bleiben.
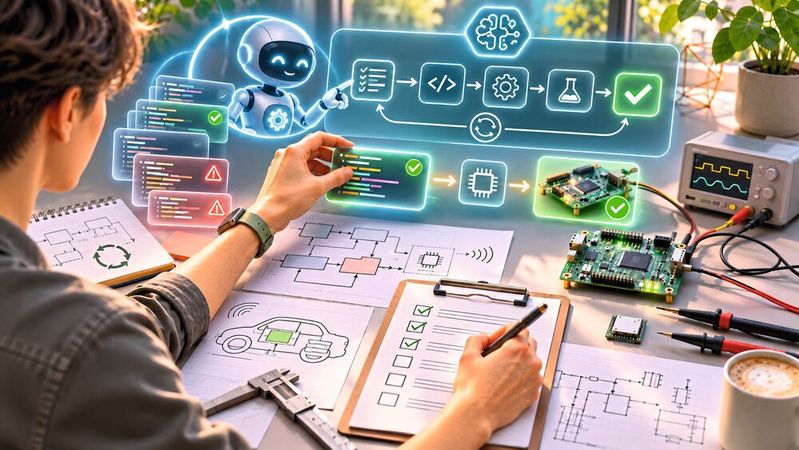
(Bild: Dall-E / KI-generiert)
Anders als klassische Code-Assistenten können KI-Agenten eigenständig Werkzeuge aufrufen, Tests ausführen und ihre Ergebnisse iterativ verbessern. In der Embedded- und Softwareentwicklung eröffnet das neue Möglichkeiten, stellt Teams aber auch vor Fragen zu Verifikation, Integration und Review-Aufwand. Christoph Stockhammer, Principal Application Engineer bei Mathworks, erläutert im Interview, welche Aufgaben sich heute für KI-Agenten eignen und woran sich ihr tatsächlicher Nutzen messen lässt. Dabei wird deutlich, warum auch bei weitreichender Automatisierung das fachliche Urteil des Ingenieurs unverzichtbar bleibt.
Herr Stockhammer, der Begriff „Agentic AI“ wird derzeit sehr unterschiedlich verwendet. Was unterscheidet einen KI-Agenten im Engineering konkret von einem Code-Assistenten oder einer klassischen Automatisierung?
Christoph Stockhammer, Mathworks: Der entscheidende Unterschied ist die Fähigkeit, externe Werkzeuge aufzurufen und deren Ergebnisse in weiteren Arbeitsschritten zu verarbeiten. Ein Code-Assistent unterstützt Entwickler meist punktuell, etwa durch Codevorschlägen, API-Erklärungen oder die Generierung einer Funktion auf Basis eines Prompts . Eine klassische Automatisierung führt dagegen eine vorab festgelegte Abfolge von Schritten nach eindeutigen Regeln aus.
Ein KI-Agent kombiniert beides: Er erhält ein Ziel, zerlegt es in Teilaufgaben, wählt geeignete Werkzeuge aus, bewertet Zwischenergebnisse und passt sein Vorgehen an. Im Engineering-Kontext erzeugt er also nicht nur Text oder Code. Er kann beispielsweise einen Compiler aufrufen, den Code kompilieren, das erzeugte Programm ausführen, die Ergebnisse prüfen und den Code anschließend überarbeiten, bis die Teilaufgabe erfüllt ist. Diese Abfolge wird als Agentic Loop bezeichnet.
Welche Aufgaben in der Embedded- und Software-Entwicklung eignen sich heute besonders für KI-Agenten? Wo liegen die größten Stärken? Können Sie anhand eines konkreten Entwicklungsablaufs erläutern, welche Schritte der Agent übernimmt, und wo das Eingreifen eines Ingenieurs weiter unverzichtbar bleibt?
Besonders geeignet sind Aufgaben, die mehrere klar definierte Engineering-Schritte verbinden, bei denen aber flexibel entschieden werden muss, wie es jeweils weitergeht. Beispiele sind die Analyse einer bestehenden Codebasis, die Entwicklung eines ersten Prototyps oder klar abgegrenzten Änderungen an einem System, das Erstellen und Erweitern von Tests, die Diagnose fehlgeschlagener Tests, das Überarbeiten von Quelltext, Dokumentation sowie wiederkehrende Analysen.
Nehmen wir eine klar umrissene Softwareänderung: Ein Ingenieur definiert Anforderungen und Abnahmekriterien. Der Agent untersucht die relevante Implementierung, identifiziert Abhängigkeiten, schlägt Änderungen vor, setzt sie um. Anschließend kann er vorhandene Tests und statische Analysen ausführen, Fehler bewerten und die Implementierung überarbeiten. Schließlich legt er die Änderungen und die zugehörigen Prüfnachweise zur Begutachtung vor.
Die Verantwortung verbleibt jedoch beim Ingenieur. Er muss beurteilen, ob die Anforderungen korrekt sind, die vorgeschlagene Architektur sinnvoll ist, die Tests das beabsichtigte Verhalten abbilden, die zugrunde liegenden Annahmen gültig sind und die Implementierung im Hinblick auf Safety, Security, Wartbarkeit und das Verhalten des Gesamtsystems akzeptabel ist. Diese Aufteilung ist wesentlich: Ein Agent kann mehr Engineering-Arbeit automatisieren, die fachliche Verantwortung lässt sich jedoch nicht im Rahmen der Ausführung auf ihn übertragen.
Welche Anwendungen haben sich bereits außerhalb vorbereiteter Demonstrationen und Pilotprojekte bewährt? Woran lässt sich erkennen, ob ein Agent auch mit gewachsenem Code, unvollständiger Dokumentation und projektspezifischen Randbedingungen zuverlässig zurechtkommt?
Stand: 08.12.2025
Es ist für uns eine Selbstverständlichkeit, dass wir verantwortungsvoll mit Ihren personenbezogenen Daten umgehen. Sofern wir personenbezogene Daten von Ihnen erheben, verarbeiten wir diese unter Beachtung der geltenden Datenschutzvorschriften. Detaillierte Informationen finden Sie in unserer Datenschutzerklärung.
Einwilligung in die Verwendung von Daten zu Werbezwecken
Ich bin damit einverstanden, dass die Vogel Communications Group GmbH & Co. KG, Max-Planckstr. 7-9, 97082 Würzburg einschließlich aller mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen (im weiteren: Vogel Communications Group) meine E-Mail-Adresse für die Zusendung von redaktionellen Newslettern nutzt. Auflistungen der jeweils zugehörigen Unternehmen können hier abgerufen werden.
Der Newsletterinhalt erstreckt sich dabei auf Produkte und Dienstleistungen aller zuvor genannten Unternehmen, darunter beispielsweise Fachzeitschriften und Fachbücher, Veranstaltungen und Messen sowie veranstaltungsbezogene Produkte und Dienstleistungen, Print- und Digital-Mediaangebote und Services wie weitere (redaktionelle) Newsletter, Gewinnspiele, Lead-Kampagnen, Marktforschung im Online- und Offline-Bereich, fachspezifische Webportale und E-Learning-Angebote. Wenn auch meine persönliche Telefonnummer erhoben wurde, darf diese für die Unterbreitung von Angeboten der vorgenannten Produkte und Dienstleistungen der vorgenannten Unternehmen und Marktforschung genutzt werden.
Meine Einwilligung umfasst zudem die Verarbeitung meiner E-Mail-Adresse und Telefonnummer für den Datenabgleich zu Marketingzwecken mit ausgewählten Werbepartnern wie z.B. LinkedIN, Google und Meta. Hierfür darf die Vogel Communications Group die genannten Daten gehasht an Werbepartner übermitteln, die diese Daten dann nutzen, um feststellen zu können, ob ich ebenfalls Mitglied auf den besagten Werbepartnerportalen bin. Die Vogel Communications Group nutzt diese Funktion zu Zwecken des Retargeting (Upselling, Crossselling und Kundenbindung), der Generierung von sog. Lookalike Audiences zur Neukundengewinnung und als Ausschlussgrundlage für laufende Werbekampagnen. Weitere Informationen kann ich dem Abschnitt „Datenabgleich zu Marketingzwecken“ in der Datenschutzerklärung entnehmen.
Falls ich im Internet auf Portalen der Vogel Communications Group einschließlich deren mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen geschützte Inhalte abrufe, muss ich mich mit weiteren Daten für den Zugang zu diesen Inhalten registrieren. Im Gegenzug für diesen gebührenlosen Zugang zu redaktionellen Inhalten dürfen meine Daten im Sinne dieser Einwilligung für die hier genannten Zwecke verwendet werden. Dies gilt nicht für den Datenabgleich zu Marketingzwecken.
Recht auf Widerruf
Mir ist bewusst, dass ich diese Einwilligung jederzeit für die Zukunft widerrufen kann. Durch meinen Widerruf wird die Rechtmäßigkeit der aufgrund meiner Einwilligung bis zum Widerruf erfolgten Verarbeitung nicht berührt. Um meinen Widerruf zu erklären, kann ich als eine Möglichkeit das unter https://contact.vogel.de abrufbare Kontaktformular nutzen. Sofern ich einzelne von mir abonnierte Newsletter nicht mehr erhalten möchte, kann ich darüber hinaus auch den am Ende eines Newsletters eingebundenen Abmeldelink anklicken. Weitere Informationen zu meinem Widerrufsrecht und dessen Ausübung sowie zu den Folgen meines Widerrufs finde ich in der Datenschutzerklärung, Abschnitt Redaktionelle Newsletter.
Christoph Stockhammer, Principal Application Engineer bei Mathworks: „Allein zu messen, wie schnell Code erzeugt wird, greift zu kurz. Entscheidend ist die Wirkung auf den gesamten Engineering-Prozess.“
(Bild: Mathworks / Sabine Franzl)
Diese Frage knüpft teilweise an die vorherige Frage an: Bewährt haben sich bereits Anwendungen wie die automatische Erstellung von Tests und Dokumentationen, die Generierung von Softwareprototypen oder die Diagnose von Fehlermeldungen. Wie gut ein Agent in einem konkreten Projekt mit gewachsenem Code oder unvollständiger Dokumentation und projektspezifischen Randbedingungen zurechtkommt, lässt sich allerdings kaum vorab beurteilen. Das zeigt sich erst im praktischen Einsatz, etwa anhand von fehlgeschlagenen Tests und notwendigen menschlichen Eingriffe sowie an der Anzahl der erforderlichen Iterationen des Agenten und am Tokenverbrauch. Mit der Zeit entwickelt man jedoch ein Gespür dafür – ähnlich wie bei einem neuen menschlichen Kollegen - welche Aufgaben man dem KI-Agenten anvertrauen kann und welche Informationen man ihm dafür zur Verfügung stellen muss.
Prompt Engineering gilt für die Zukunft als eine der wichtigsten Fähigkeiten im Umgang mit KI: Das Talent, Anweisungen gekonnt zu formulieren, damit der KI-Agent auch das bestmögliche gewünschte Ergebnis liefern kann. Welche Rolle spielen klar formulierte Anforderungen, Model-Based Design und automatisierte Tests für den Nutzen agentischer KI?
Gute Prompts sind wichtig. Im Engineering ist jedoch die Qualität des fachlichen Kontexts, den ein Agent erhält, noch entscheidender. Softwareteams müssen unter anderem für Konsistenz bei der Strukturierung von Code, der Formulierung von Tests und der Integration in eine CI/CD-Pipeline sorgen. Der Agent muss diese Vorgaben kennen.
Auch ein ausgefeilter Prompt kann mehrdeutige Anforderungen oder fehlende Abnahmekriterien nicht ausgleichen. Klar formulierte Anforderungen beschreiben die beabsichtigte Funktion. Modelle bilden das Systemverhalten ausführbar und analysierbar ab. Automatisierte Tests liefern Nachweise dafür, ob eine Implementierung die definierten Erwartungen erfüllt.
Hier kann Model-Based Design agentische KI sinnvoll ergänzen. Statt ausschließlich aus natürlicher Sprache und Quellcode Schlussfolgerungen zu ziehen, kann der Agent strukturierte Engineering-Artefakte nutzen, die Systemverhalten und Randbedingungen explizit darstellen. Die künftig erforderliche Kompetenz geht deshalb über Prompt Engineering hinaus: Ingenieure müssen Ziele, Randbedingungen, Kontext und Prüfkriterien so formulieren, dass Menschen und KI-gestützte Werkzeuge damit arbeiten können.
Oft steht die Frage des tatsächlich gewonnenen praktischen Nutzens im Raum. Wie sollten oder können Unternehmen den Nutzen eines KI-Agenten über den gesamten Entwicklungsablauf messen – einschließlich Integration, Review, Nacharbeit und Betriebskosten?
Antwort
Allein zu messen, wie schnell Code erzeugt wird, greift zu kurz. Entscheidend ist die Wirkung auf den gesamten Engineering-Prozess. Unternehmen sollten die vollständigen Kosten einer Änderung betrachten: den Aufwand für die Spezifikation der Aufgabe, die Ausführung durch den Agenten, Rechenleistung und Werkzeuge, Integration, Review, Korrekturen und Tests sowie mögliche weitere Nacharbeiten aufgrund von Fehlern oder Problemen bei der Wartbarkeit.
Die exakte Berechnung der tatsächlichen Kosten sowie die Bewertung des Nutzens hängen stark vom jeweiligen Anwendungsfall ab und können je nach Sachlage unterschiedlich komplex sein. Es empfiehlt sich für eine solche Bewertung zunächst eine Anwendung zu betrachten, die repräsentativ für ähnliche Aufgaben im Unternehmen ist und für die historische Daten oder Erfahrungswerte zu Entwicklungsaufwand und Kosten vorliegen. So lässt sich sukzessive der tatsächliche Nutzen eines KI-Agenten auf Basis von Vorgehensweisen ermitteln.
Innovate Your Software – for a Smarter Future
Deutschlands Leitkongress der Embedded-Softwarebranche
Das Programm des ESE Kongress umfasst über 100 Seminare und Vorträge sowie 3 Keynotes. Seien Sie dabei, wenn sich die Embedded-Software-Community trifft, und nutzen Sie Diskussionen und Expertengespräche für einen ergiebigen Wissenstransfer und erfolgreiches Networken. Während der vier Kongresstage erwartet Sie zudem eine große Fachausstellung mit den führenden Firmen der Branche. Erfahren Sie alles über die neuesten Trends, Herausforderungen und Lösungen im Embedded Software Engineering, von KI, Safety und Security bis hin zu Management und Innovation.
Wie viel Systemverständnis braucht ein Coding Agent?
Das hängt stark vom Umfang der Aufgabe ab. Für eine lokale Codeänderung genügt möglicherweise ein relativ begrenzter Kontext. Eine Änderung, die Schnittstellen, Zeitverhalten, Systemarchitektur, Regelungsverhalten, Hardwareabhängigkeiten oder Safety-Eigenschaften betrifft, erfordert erheblich mehr Verständnis auf Systemebene.
Daraus ergibt sich ein praktischer Grundsatz: Der Handlungsspielraum eines Agenten sollte stets sein als der Kontext und die Verifikationsmöglichkeiten, die ihm zur Verfügung stehen. Mehr Autonomie bei unzureichendem Systemkontext erhöht das Risiko von Lösungen, die lokal plausibel, aus Sicht des Gesamtsystems aber falsch sind. Die Herausforderung besteht deshalb darin, den passenden Engineering-Kontext bereitzustellen: relevante Anforderungen, Schnittstellen, Modelle, Abhängigkeiten, Randbedingungen und Verifikationsmechanismen.
Mathworks betont die Verbindung probabilistischer Sprachmodelle mit deterministischen Berechnungen. Doch auch eine korrekt ausgeführte Berechnung kann auf falschen Annahmen oder einem ungeeigneten Modell beruhen. Welche zusätzliche Absicherung ist erforderlich, damit aus einem ausführbaren Ergebnis eine fachlich belastbare Lösung wird?
Eine deterministische Berechnung kann belegen, dass sich ein bestimmtes Ergebnis reproduzieren lässt. Sie belegt jedoch nicht, dass Fragestellung, Annahmen, Modell oder Abnahmekriterien richtig gewählt wurden.
Diese Unterscheidung zwischen Verifikation und Validierung ist im Engineering grundlegend. Die Verifikation beantwortet die Frage, ob ein System gemäß seiner Spezifikation korrekt entwickelt wurde. Die Validierung prüft, ob das richtige System für den vorgesehenen Zweck entwickelt wird.
Agentische Workflows benötigen deshalb mehrere Ebenen von Nachweisen. Dazu können explizite Anforderungen, nachvollziehbare Annahmen, Simulationen, unabhängige Tests, statische Analysen, Vergleiche mit bekanntem Referenzverhalten und Engineering-Reviews gehören. Bei bestimmten Anwendungen sind zusätzlich physikalische Messungen oder eine Validierung auf Systemebene erforderlich. Der entscheidende Punkt ist: die Ausführung einer Berechnung oder die Simulation eines Systems liefern einen Nachweis , beweisen jedoch nicht zwingend, dass die Lösung ingenieurtechnisch richtig ist. Eine mathematisch korrekte Antwort auf die falsche fachliche Frage bleibt eine falsche Engineering-Antwort.
Wenn ein Agent sowohl Implementierung als auch Testfälle erstellt, könnten beide denselben Denkfehler enthalten. Wie lässt sich eine hinreichend unabhängige Prüfung organisieren, und welche Prüfmaßstäbe müssen außerhalb des Zugriffs des Agenten festgelegt bleiben?
Das ist ein reales Risiko. Wenn Implementierung und Verifikation aus demselben Schlussfolgerungsprozess und denselben Annahmen hervorgehen, kann ein Test den Fehler der Implementierung lediglich wiederholen.
Deshalb müssen die maßgeblichen Referenzen unabhängig bleiben. Anforderungen und kritische Abnahmekriterien dürfen nicht allein aus der generierten Implementierung abgeleitet werden. Bestehende Regressionstests, unabhängig spezifiziertes Sollverhalten, Referenzmodelle, formale Eigenschaften, Programmier- und Safety-Standards sowie menschliche Reviews können unabhängige Kontrollen schaffen.
Bei kritischen Funktionen sollten Unternehmen außerdem die Erzeugung der Implementierung von den Verifikationsaktivitäten trennen. Abhängig von Anwendung und Absicherungsbedarf kann dies durch getrennte Coding-Agenten, unabhängig erstellte Testspezifikationen oder menschliche Reviews erfolgen. Der Agent darf nicht zugleich die Lösung und sämtliche Kriterien festlegen, anhand derer diese Lösung bewertet wird.
Ein Kritikpunkt, der immer häufiger im Zusammenhang von mittels Coding Agents erzeugtem Code genannt wird, betrifft Reviews: Die Prüfung des resultierenden Codes, auch Sauberkeit und Sicherheit. Auch hört man häufig, dass KI-generierter Code oft Redundanzen enthält, die erst spät und nach intensiver Prüfung auffallen. Diese Reviews kosten Zeit und Aufwand und bergen die Gefahr eines neuen, teuren und zeitaufwändigen Flaschenhalses. Wie sollen Unternehmen, Teams oder Entwickler sinnvoll mit Coding Agents umgehen, um dies zu vermeiden?
Dies birgt erhebliches Risikopotenzial: Ein Agent kann Code deutlich schneller erzeugen, als Ingenieure ihn prüfen können. Dadurch könnte sich ein Engpass an Entwicklungsressourcen lediglich in eine spätere Phase des Entwicklungsprozesses verlagern.
Die Lösung besteht nicht darin, Reviews abzuschwächen, sondern gezielt zu steuern, was überhaupt in das Review gelangt. Agenten sollten an klar abgegrenzten Änderungen arbeiten, etablierte Programmierrichtlinien einhalten, vorhandene Abstraktionen sinnvoll wiederverwenden und automatisierte Qualitätsprüfungen durchlaufen, bevor sie Änderungen zur menschlichen Prüfung vorlegen.
Teams sollten den Review-Aufwand zudem in die Produktivitätsbewertung einbeziehen. Wenn ein Agent eine Änderung in wenigen Minuten erstellt, anschließend aber mehrere Stunden für Prüfung und Bereinigung anfallen, entsteht unter dem Strich möglicherweise kein Produktivitätsgewinn. Eine erfolgreiche Einführung einer neuen Funktionalität hängt daher ebenso stark von der Gestaltung der Workflows ab wie von den Fähigkeiten des KI-Modells und des Agenten. Das Ziel sollte darin bestehen, technische Ergebnisse zu überprüfen und zu verifizieren und nicht darin, die Menge an generiertem Code zu maximieren.
Der Einsatz von KI-Agenten hat auch Auswirkungen auf die Entwicklung von Security- oder Safety-kritischen Systemen. Welche zusätzlichen Nachweise werden erforderlich, wenn KI-Agenten an Software für sicherheitskritische Systeme mitarbeiten?
In vielen Fällen sind tatsächlich keine oder kaum zusätzliche Nachweise erforderlich. Das mag überraschend klingen; also warum?
Unternehmen müssen für sicherheitskritische Systeme in jedem Fall nachweisen, dass die resultierende Software die geltenden Anforderungen und Entwicklungsprozesse erfüllt, völlig unabhängig davon, ob einzelne Teile manuell oder mit Unterstützung von KI erstellt wurden. Dazu braucht es eine durchgängige Nachverfolgbarkeit zwischen Anforderungen, Implementierung, Verifikationsergebnissen und Review-Nachweisen. Anders gesagt: Es ist weniger entscheidend, ob der Autor der Software ein Mensch oder ein KI-Agent war. Die Qualität der Software kann und wird in beiden Fällen ohnehin von Situation zu Situation, von Mensch zu Mensch, von KI zu KI schwanken. Viel wichtiger ist es, dass die einschlägigen bestehenden Safety-, Security-, Programmier- und Prozessstandards konsequent angewendet werden.
Welche Kompetenzen müssen Unternehmen aufbauen, damit Entwickler KI-Agenten sinnvoll anleiten und kritisch kontrollieren können?
Entwickler benötigen weiterhin fundierte Engineering-Kenntnisse. Agentische KI kann diese Kompetenzen sogar noch wichtiger machen, weil Ingenieure künftig häufiger Lösungen prüfen und bewerten, statt jede Codezeile selbst zu schreiben.
Zu den zentralen Fähigkeiten zählen Requirements Engineering, Systemarchitektur, Software- und Modelldesign, Verifikation und Validierung, Testen, ein Bewusstsein für Safety und Security sowie die Fähigkeit, falsche Annahmen zu erkennen.
Hinzu kommen neue Kompetenzen: Ingenieure müssen Aufgaben für Agenten sinnvoll zerlegen, den erforderlichen Kontext bereitstellen, Randbedingungen und Abnahmekriterien definieren und beurteilen können, wo KI-Systeme besonders produktiv arbeiten und wo ihre Grenzen liegen. Entscheidend ist die Fähigkeit, einen Engineering-Prozess zu gestalten, in dem sich KI-generierte Arbeit integrieren, kritisch hinterfragen und verifizieren lässt.
Welche technischen oder organisatorischen Lücken begrenzen den produktiven Einsatz derzeit am stärksten?
Antwort
Eine zentrale Herausforderung ist der Kontext. Engineering-Wissen verteilt sich häufig auf Quellcode, Modelle, Anforderungen, Issue-Tracker, Testsysteme, Dokumentation, Simulationsergebnisse und die Erfahrung einzelner Ingenieure. Dem Agenten den relevanten Kontext vollständig und sicher bereitzustellen, ohne ihn mit irrelevanten Informationen zu belasten, ist anspruchsvoll.
Eine zweite Herausforderung ist die Verifikation. Eine Antwort zu erzeugen ist einfacher, als nachzuweisen, dass sie für ein bestimmtes Engineering-System korrekt ist. Die dritte Herausforderung liegt in der Integration in bestehende Workflows. Agenten müssen sich in etablierte Entwicklungs-, Review-, Test-, Konfigurationsmanagement-, Security- und Compliance-Prozesse einfügen, statt einen parallelen Prozess außerhalb der vorhandenen Engineering-Kontrollen zu bilden.
Schließlich benötigen Unternehmen geeignete Governance-Regeln: Wo dürfen Agenten autonom handeln? Wo sind Freigaben erforderlich? Wie werden generierte Artefakte nachverfolgt? Und wie wird Verantwortung zugewiesen? Die entscheidende Frage lautet deshalb nicht nur, wie leistungsfähig die zugrunde liegenden Sprachmodelle werden. Ebenso wichtig ist, wie wir probabilistische KI mit Engineering-Kontext, deterministischen Werkzeugen, Verifikation, Nachverfolgbarkeit und menschlichem Urteilsvermögen verbinden. (sg)