Wenn sich ein eingebettetes System nicht wie erwartet verhält, kann die Suche nach der Ursache eine mühsame Aufgabe sein. Insbesondere in Systemen, die ein Echtzeitbetriebssystem erfordern, stoßen herkömmliche Debugging-Methoden möglicherweise an ihre Grenzen. Teil 1 der zweiteiligen Artikelreihe befasst sich eingehend mit Software-Tracing und -Instrumentierung.
Debugging des Unsichtbaren: Software-Tracing und passende Trace-Infrastruktur sind wertvolle Werkzeuge bei der Fehlersuche in einem Embedded-Echtzeitbetriebssystem.
(Bild: Green Hills via Gen AI/Shutterstock.)
Moderne eingebettete Systeme werden immer komplexer. Anwendungen, die früher aus wenigen Tasks bestanden und die auf einem einzigen Mikrocontroller liefen, kombinieren heute mehrere Softwarekomponenten, Kommunikationsstacks, Sicherheitsfunktionen und Echtzeitdienste, die unter strengen zeitlichen Vorgaben zuverlässig arbeiten müssen.
Mit zunehmender Komplexität steigt auch der Bedarf an Beobachtbarkeit zur Laufzeit. Wenn ein System eine Deadline verpasst, unerwartete Latenzen aufweist oder sich unter realen Arbeitslasten anders verhält als während der Tests, benötigen Entwickler Einblick in die Vorgänge im Zielsystem. Herkömmliche Debugging-Techniken sind für die Funktionsanalyse nach wie vor wertvoll, haben jedoch oft Schwierigkeiten, zeitbezogene Probleme aufzudecken. Gleichzeitig stehen Hardware-Trace-Lösungen aufgrund von Kosten, Plattformbeschränkungen oder Einsatzbeschränkungen nicht immer zur Verfügung. In solchen Situationen bietet softwarebasiertes Tracing einen praktischen Weg, die Beobachtbarkeit zu verbessern, ohne das Systemverhalten grundlegend zu verändern.
Warum klassisches Debugging nicht reicht
Die meisten Embedded-Entwickler sind mit Breakpoints, Überwachungsfenstern und der Single-Step-Ausführung vertraut. Diese Techniken sind äußerst effektiv, wenn es darum geht, funktionale Probleme zu untersuchen oder bestimmte Codeabschnitte zu validieren.
Sie verlieren jedoch an Nutzen, wenn das Problem mit dem Timing, der Ablaufplanung oder den Interaktionen zwischen parallellaufenden Softwarekomponenten zusammenhängt. Das Anhalten eines Echtzeitsystems verändert dessen Verhalten. Aufgaben werden nicht mehr ausgeführt, Interrupts verzögert, und Kommunikationsschnittstellen verhalten sich womöglich nicht mehr so, wie sie es im Normalbetrieb tun würden. Dadurch kann der Vorgang des Debuggens genau das Problem verbergen, das Ingenieure zu diagnostizieren versuchen.
Diese Herausforderung wird in Systemen, auf denen ein Echtzeitbetriebssystem (RTOS) läuft, noch deutlicher. Scheduling-Entscheidungen, Synchronisationsmechanismen und Interrupt-Aktivitäten finden kontinuierlich statt und hängen oft von präzisen zeitlichen Beziehungen ab. Um diese Interaktionen zu erfassen, muss das System während des normalen Betriebs beobachtet werden.
Das Tracing erfüllt diese Anforderung, indem es Laufzeitereignisse aufzeichnet, ohne die Ausführung anzuhalten. Anstatt eine Momentaufnahme des Systems zu einem bestimmten Zeitpunkt zu liefern, erfasst das Tracing, wie sich das System über einen längeren Zeitraum verhält. Dies ermöglicht es Entwicklern, den Ausführungsablauf zu rekonstruieren, Aufgabeninteraktionen zu verstehen und zeitliche Anomalien zu identifizieren, die andernfalls unsichtbar blieben. Deshalb sollte Tracing nicht als Ersatz für Debugging betrachtet werden, sondern als gegenseitige Ergänzung: Debugging liefert detaillierte Einblicke in bestimmte Ausführungszustände, während Tracing den zeitlichen Kontext bereitstellt, der zum Verständnis des gesamten Systemverhaltens erforderlich ist.
Software-Tracing zur Beobachtbarkeit
Software-Tracing umfasst eine Reihe von Techniken, die darauf ausgelegt sind, Informationen aufzuzeichnen, während das System normal weiterläuft. Solche Techniken stehen in modernen eingebetteten RTOS-Umgebungen zur Verfügung, darunter µ-velOSity und INTEGRITY RTOS von Green Hills Software, bei denen die Laufzeit-Beobachtbarkeit in das Betriebssystem und die Entwicklungswerkzeuge integriert werden kann.
Ein gängiger Ansatz ist ereignisbasiertes Tracing. Hierbei zeichnet das System Events wie Task-Aktivierungen, Kontextwechsel, Ausführung von Interrupts, Synchronisationsvorgänge oder Zustandsübergänge auf. Durch Analyse dieser Ereignisse können Entwickler Einblicke in das Verhalten des Schedulers, Reaktionsfähigkeit des Systems und allgemeine Ausführungsmuster gewinnen.
Ein weiterer Ansatz ist das Tracing auf Funktionsebene, bei dem Ein- und Ausstiegspunkte von Funktionen automatisch aufgezeichnet werden. Dies ermöglicht es, Ausführungswege zu rekonstruieren und unerwartete Kontrollflussverläufe zu identifizieren. Das Funktions-Tracing kann zudem dabei helfen, festzustellen, wo Ausführungszeit verbraucht wird, und Codepfade aufzudecken, die häufiger als erwartet ausgeführt werden.
Anwendungsspezifische Trace-Ereignisse bieten zusätzliche Transparenz. Entwickler können Trace-Punkte einfügen, die für den Anwendungsbereich relevante Informationen aufzeichnen, etwa Betriebsmodi, Sensorwerte, Kommunikationsereignisse oder Fehlerzustände. Diese Ereignisse helfen dabei, Systemaktivitäten auf niedriger Ebene mit dem Anwendungsverhalten auf höherer Ebene in Zusammenhang zu bringen.
Stand: 08.12.2025
Es ist für uns eine Selbstverständlichkeit, dass wir verantwortungsvoll mit Ihren personenbezogenen Daten umgehen. Sofern wir personenbezogene Daten von Ihnen erheben, verarbeiten wir diese unter Beachtung der geltenden Datenschutzvorschriften. Detaillierte Informationen finden Sie in unserer Datenschutzerklärung.
Einwilligung in die Verwendung von Daten zu Werbezwecken
Ich bin damit einverstanden, dass die Vogel Communications Group GmbH & Co. KG, Max-Planckstr. 7-9, 97082 Würzburg einschließlich aller mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen (im weiteren: Vogel Communications Group) meine E-Mail-Adresse für die Zusendung von redaktionellen Newslettern nutzt. Auflistungen der jeweils zugehörigen Unternehmen können hier abgerufen werden.
Der Newsletterinhalt erstreckt sich dabei auf Produkte und Dienstleistungen aller zuvor genannten Unternehmen, darunter beispielsweise Fachzeitschriften und Fachbücher, Veranstaltungen und Messen sowie veranstaltungsbezogene Produkte und Dienstleistungen, Print- und Digital-Mediaangebote und Services wie weitere (redaktionelle) Newsletter, Gewinnspiele, Lead-Kampagnen, Marktforschung im Online- und Offline-Bereich, fachspezifische Webportale und E-Learning-Angebote. Wenn auch meine persönliche Telefonnummer erhoben wurde, darf diese für die Unterbreitung von Angeboten der vorgenannten Produkte und Dienstleistungen der vorgenannten Unternehmen und Marktforschung genutzt werden.
Meine Einwilligung umfasst zudem die Verarbeitung meiner E-Mail-Adresse und Telefonnummer für den Datenabgleich zu Marketingzwecken mit ausgewählten Werbepartnern wie z.B. LinkedIN, Google und Meta. Hierfür darf die Vogel Communications Group die genannten Daten gehasht an Werbepartner übermitteln, die diese Daten dann nutzen, um feststellen zu können, ob ich ebenfalls Mitglied auf den besagten Werbepartnerportalen bin. Die Vogel Communications Group nutzt diese Funktion zu Zwecken des Retargeting (Upselling, Crossselling und Kundenbindung), der Generierung von sog. Lookalike Audiences zur Neukundengewinnung und als Ausschlussgrundlage für laufende Werbekampagnen. Weitere Informationen kann ich dem Abschnitt „Datenabgleich zu Marketingzwecken“ in der Datenschutzerklärung entnehmen.
Falls ich im Internet auf Portalen der Vogel Communications Group einschließlich deren mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen geschützte Inhalte abrufe, muss ich mich mit weiteren Daten für den Zugang zu diesen Inhalten registrieren. Im Gegenzug für diesen gebührenlosen Zugang zu redaktionellen Inhalten dürfen meine Daten im Sinne dieser Einwilligung für die hier genannten Zwecke verwendet werden. Dies gilt nicht für den Datenabgleich zu Marketingzwecken.
Recht auf Widerruf
Mir ist bewusst, dass ich diese Einwilligung jederzeit für die Zukunft widerrufen kann. Durch meinen Widerruf wird die Rechtmäßigkeit der aufgrund meiner Einwilligung bis zum Widerruf erfolgten Verarbeitung nicht berührt. Um meinen Widerruf zu erklären, kann ich als eine Möglichkeit das unter https://contact.vogel.de abrufbare Kontaktformular nutzen. Sofern ich einzelne von mir abonnierte Newsletter nicht mehr erhalten möchte, kann ich darüber hinaus auch den am Ende eines Newsletters eingebundenen Abmeldelink anklicken. Weitere Informationen zu meinem Widerrufsrecht und dessen Ausübung sowie zu den Folgen meines Widerrufs finde ich in der Datenschutzerklärung, Abschnitt Redaktionelle Newsletter.
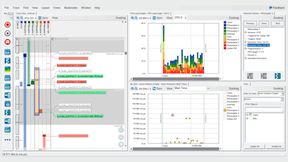
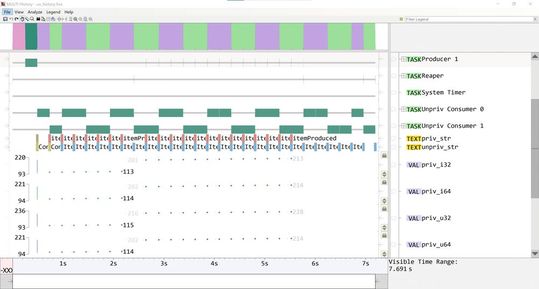
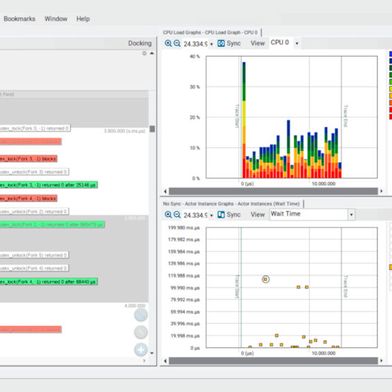
Bild 1: Kombinierte Visualisierung von Aufgabenausführung, Anwendungsereignissen, Variablenwerten und kompakten Protokollmeldungen in MULTI History.
(Bild: Green Hills Software)
Im Gegensatz zu herkömmlichen Protokollierungsmethoden sind moderne Software-Trace-Mechanismen so konzipiert, dass sie mit begrenztem Overhead arbeiten. Trace-Daten werden in der Regel in Speicherpuffern mithilfe schlanker APIs gespeichert, die aufwendige Formatierungsvorgänge vermeiden und die Beeinträchtigung der Echtzeitausführung minimieren. Das Ergebnis ist ein kontinuierlicher Strom von Laufzeitinformationen, der analysiert werden kann, ohne das Systemverhalten wesentlich zu beeinträchtigen.
Wie Bild 1 zeigt, kann die Software-Trace-Funktion verschiedene Arten von Laufzeitinformationen entlang einer gemeinsamen Zeitachse kombinieren. Ereignisse zur Aufgabenausführung und zum Kontextwechsel geben Aufschluss über das Verhalten des Schedulers, während anwendungsspezifische Ereignisse dabei helfen, Aufgabenaktivitäten mit Systemvorgängen in Zusammenhang zu bringen. Variablen können zudem über einen bestimmten Zeitraum hinweg überwacht werden, wodurch Änderungen im Anwendungszustand direkt sichtbar werden. Darüber hinaus können Entwickler mithilfe von Trace-APIs ressourcenschonende Textmeldungen einfügen und so Diagnoseinformationen bereitstellen – und das mit deutlich geringerem Overhead als bei herkömmlicher, printf-basierender Protokollierung, die eine Formatierung zur Laufzeit erfordert und möglicherweise E/A-Operationen blockiert.
Compiler-gestützte Instrumentierung
Eine der größten Herausforderungen bei der Software-Trace-Analyse ist die Entscheidung, wo Trace-Ereignisse generiert werden sollen. Das manuelle Einfügen von Trace-Aufrufen in einer umfangreichen Codebasis ist zeitaufwendig, fehleranfällig und schwer zu warten.
Die compilerunterstützte Instrumentierung bietet eine skalierbarere Lösung. Anstatt den Quellcode zu ändern, fügt der Compiler während des Build-Prozesses automatisch Instrumentierungspunkte ein. Ereignisse beim Ein- und Aussteigen aus Funktionen können automatisch generiert werden, sodass Entwickler den Ausführungsablauf beobachten können, ohne den Anwendungscode manuell bearbeiten zu müssen.
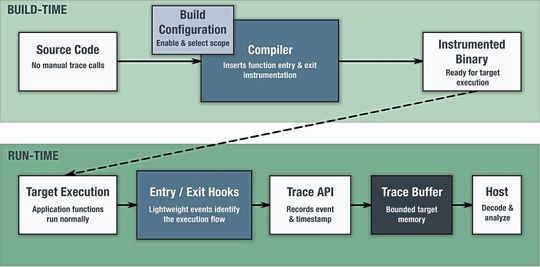
Bild 2: Compiler-gestützte Instrumentierung von der Konfiguration zur Kompilierungszeit bis zur Erfassung von Tracing-Daten zur Laufzeit und der Analyse auf dem Host.
(Bild: Green Hills Software)
Wie in Bild 2 dargestellt, fügt der Compiler automatisch Instrumentierungen für Funktionseinstieg und -ausstieg entsprechend der ausgewählten Build-Konfiguration ein, ohne dass manuelle Trace-Aufrufe im Quellcode erforderlich sind. Die daraus resultierende instrumentierte Binärdatei wird auf dem Zielsystem ausgeführt, wo leichtgewichtige Hooks über die Trace-API zeitgestempelte Ereignisse generieren. Diese Ereignisse werden in einem begrenzten Trace-Puffer gespeichert und anschließend zur Dekodierung und Analyse an den Host übertragen.
Der Ansatz bietet mehrere Vorteile. Änderungen am Quellcode werden auf ein Minimum reduziert, was besonders in sicherheitskritischen Umgebungen wertvoll ist, in denen Codeänderungen zusätzliche Überprüfungs- und Verifizierungsmaßnahmen erfordern. Ferner lässt sich die Instrumentierung über die Build-Konfiguration aktivieren oder deaktivieren, sodass dieselbe Codebasis für Entwicklung, Tests und Bereitstellung verwendet werden kann.
Skalierbarkeit ist ein weiterer wichtiger Vorteil. Mit zunehmender Größe von Softwareprojekten wird die Pflege der manuellen Instrumentierung immer schwieriger. Compiler-gestützte Methoden ermöglichen es, dass die Beobachtungsfähigkeiten mit der Anwendung mitwachsen, bei überschaubarem Wartungsaufwand.
Natürlich verursacht die Instrumentierung zusätzlichen Ausführungsaufwand und erhöht die Code-Größe. Die Auswirkungen hängen von der Anzahl der Instrumentierungspunkte, der Häufigkeit der Trace-Ereignisse und der Effizienz der zugrunde liegenden Trace-Infrastruktur ab. Darum setzen viele Projekte auf selektive Instrumentierung und konzentrieren sich dabei nur auf kritische Module oder Bereiche von Interesse, anstatt jede Funktion im System zu verfolgen. Das Ziel ist es, ein Gleichgewicht zwischen Transparenz und Leistung zu erreichen.
Von Ereignissen zur Trace-Infrastruktur
Die Erzeugung von Trace-Ereignissen ist nur der erste Schritt hin zu einer effektiven Laufzeitbeobachtbarkeit. Sobald Ereignisse erzeugt wurden, müssen sie gesammelt, gespeichert, mit einem Zeitstempel versehen und schließlich an eine Analyseumgebung übertragen werden. Die Mechanismen, die für diese Aktivitäten zuständig sind, bilden die Trace-Infrastruktur.
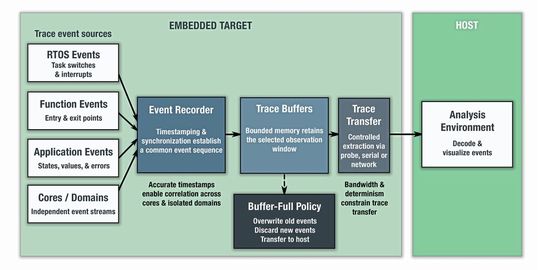
Bild 3: Software-Trace-Infrastruktur von der Ereigniserzeugung auf dem eingebetteten Zielsystem bis zur Analyse auf dem Host.
(Bild: Green Hills Software)
Bild 3 zeigt eine Software-Trace-Infrastruktur. Trace-Ereignisse, die vom RTOS, von instrumentierten Funktionen, von Anwendungssoftware sowie von isolierten Kernen oder Domänen generiert werden, werden von einem gemeinsamen Ereignisrekorder erfasst. Durch Zeitstempelung und Synchronisation können Ereignisse aus verschiedenen Quellen entlang einer konsistenten Zeitsequenz korreliert werden. Die gesammelten Daten werden in begrenzten Trace-Puffern gespeichert, deren Überlaufregelung bestimmt, ob ältere Ereignisse überschrieben, neue Ereignisse verworfen oder Daten an den Host übertragen werden. Eine kontrollierte Extraktion über eine Debug-Sonde, eine serielle Schnittstelle oder eine Netzwerkverbindung sorgt für ein Gleichgewicht zwischen der verfügbaren Bandbreite und der Vermeidung von Störungen der deterministischen Ausführung. Die Analyseumgebung auf dem Host decodiert und visualisiert anschließend die Trace-Daten.
In einem Echtzeitsystem muss diese Infrastruktur mit derselben Sorgfalt hinsichtlich der Vorhersagbarkeit konzipiert werden wie die Anwendung selbst. Puffergröße und Überlaufregeln bestimmen, wie viel Trace-Verlaufsspeicher beibehalten werden kann und welche Informationen möglicherweise verloren gehen. Synchronisation und Zeitstempelung beeinflussen sowohl den Ausführungs-Overhead als auch die Fähigkeit, Ereignisabläufe genau zu rekonstruieren. Die Übertragung von Trace-Daten an den Host bringt weitere Kompromisse zwischen Bandbreite, Vollständigkeit und unterbrechungsfreier, deterministischer Ausführung mit sich.
Diese Überlegungen gewinnen noch mehr an Bedeutung, wenn verschiedene Prozessorklassen, mehrere Kerne oder isolierte Softwaredomänen beteiligt sind. Eine vollständige Beobachtungslösung muss daher die Ereigniserzeugung auf dem Zielsystem mit einer effizienten Erfassung, einer kontrollierten Extraktion und einer hostseitigen Analyse verbinden.
Zeitliche Fehler in eingebetteten RTOS-Systemen lassen sich nicht immer durch Debugging-Techniken nachvollziehen, die die Ausführung unterbrechen. Die Software-Trace-Erfassung liefert den zeitlichen Kontext, der erforderlich ist, um Scheduling, Interrupts, Synchronisation, Kontrollfluss und das Verhalten auf Anwendungsebene zu beobachten, während das System weiterläuft.
Ereignisbasiertes Tracing, Tracing auf Funktionsebene und anwendungsspezifische Ereignisse bieten sich ergänzende Formen der Transparenz, während die Compiler-gestützte Instrumentierung das Funktions-Tracing skalierbar macht und den Bedarf an Änderungen am Quellcode verringert. Diese Vorteile müssen jedoch weiterhin gegen den Ausführungs-Overhead und die Zunahme der Code-Größe abgewogen werden, was selektives Instrumentieren zu einer wichtigen praktischen Technik macht. (sg)
* Dr. Carmelo Loiacono ist Field Applications Engineer bei Green Hills Software