KI-Agenten können Code erzeugen, analysieren und verändern. Beim Embedded Debugging brauchen sie zusätzlich Zugriff auf Register, Speicher und Laufzeitdaten. Neue Ansätze verbinden sie deshalb direkt mit Debuggern und realer Hardware, um Fehler gezielt zu finden und schnell zu beheben.
(Bild: Jetbrains)
Künstliche Intelligenz (KI) hat sich in der Softwareentwicklung innerhalb kurzer Zeit vom reinen Assistenten für das Vervollständigen von Code zum aktiven Agenten entwickelt. KI-Agenten erzeugen Code, analysieren Fehler in vorhandenem Code und schlagen Änderungen vor.
Im Embedded-Bereich stößt der Ansatz jedoch schnell an seine Grenzen: Ein Agent, der lediglich Quellcode und Logs analysiert, sieht nicht den tatsächlichen Zustand des Zielsystems. Hierbei können Registerinhalte, Speicherzustände oder Stack Frames für die Ursachenanalyse genauso wichtig sein wie die betreffende Codezeile selbst.
Aus diesem Grund versucht die Open-Source-Community in mehreren unabhängigen Projekten, GNU Debugger (GDB) mit KI-Agenten zu verbinden und ihnen so Zugriff auf reale Debug-Sessions zu ermöglichen. Das Problem dabei: Zu einer ohnehin heterogenen Toolchain aus unterschiedlichen Debug-Probes, Software Development Kits (SDKs) und Analysewerkzeugen kommt eine weitere Integrationsschicht hinzu.
Die Grenzen bisheriger Coding-KI überwinden
Ein Large Language Model (LLM) kann beispielsweise aus dem Quellcode, der Dokumentation, den Compiler-Ausgaben oder den Log-Daten bereits viele Rückschlüsse zum Systemzustand und zur Codebasis ziehen. In Embedded-Systemen entsteht ein Fehler allerdings häufig erst mit dem Zusammenspiel aus Software und Hardware und beim Testen des Codes. So kann beispielsweise ein falscher Pointer erst unter einer bestimmten Speicherbelegung zum Absturz führen. Zusätzlich können Aspekte wie Timing, Peripheriezustände oder Interrupts das Verhalten des Systems beeinflussen.
Ohne den direkten Hardwarekontext bleibt dem KI-Agenten deshalb häufig nur zu vermuten wo der Fehler entsteht. Er kann erkennen, welche Codezeile verdächtig erscheint, jedoch nicht selbst überprüfen, welcher Wert tatsächlich in einem Register stand, welche Speicheradresse angesprochen oder welche Instruktion unmittelbar vor dem Fehler ausgeführt wurde.
Gleichzeitig arbeiten Embedded-Teams ohnehin mit unterschiedlichen Debug-Probes sowie herstellerspezifischen SDKs und Analysewerkzeugen. Kommt nun für jeden Einsatzbereich zusätzlich eine separate KI- oder GDB-Brücke hinzu, entsteht eine weitere Integrations- und Wartungsebene.
Laut einer JetBrains-Studie verbringen Entwickler rund 19 Prozent ihrer Zeit in der IDE mit Debugging. KI-gestütztes Debugging kann dazu beitragen, diesen Aufwand zu reduzieren, indem Teile der Diagnose automatisiert, relevante Laufzeitinformationen gesammelt und mögliche Fehlerursachen eingegrenzt werden. Dadurch bleibt Entwicklern mehr Zeit, sich auf die eigentliche Bewertung, Behebung und Validierung von Fehlern zu konzentrieren.
Mit dem Einsatz von KI beim Debugging entsteht jedoch eine Vertrauensfrage: Gerade in Automotive-Projekten mit Vorgaben wie MISRA oder AUTOSAR genügt es nicht, wenn ein Agent lediglich behauptet, eine Fehlerursache gefunden zu haben. Die Diagnose muss nachvollziehbar und belegbar sein.
Wenn der KI-Agent Teil der Debug-Session wird
An der Stelle setzt der in CLion integrierte Ansatz an. Statt den KI-Agenten als separates Werkzeug neben die bestehende Toolchain zu stellen, bindet ihn der Hersteller in den Debugging-Kontext der IDE ein. Über das Agent Client Protocol (ACP) können Entwickler unterschiedliche Agenten integrieren und müssen sich nicht auf ein einzelnes Modell oder einen einzelnen KI-Anbieter festlegen.
Mit Version 2026.2 kam ein spezieller Debugger-Skill hinzu. Er ermöglicht kompatiblen KI-Agenten, Informationen wie Stack-Traces, Breakpoints und Variablenwerte in ihre Analyse einzubeziehen und arbeitet mit GDB und LLDB sowie mit Debug Adapter Protocol (DAP)-basierten Debuggern.
Stand: 08.12.2025
Es ist für uns eine Selbstverständlichkeit, dass wir verantwortungsvoll mit Ihren personenbezogenen Daten umgehen. Sofern wir personenbezogene Daten von Ihnen erheben, verarbeiten wir diese unter Beachtung der geltenden Datenschutzvorschriften. Detaillierte Informationen finden Sie in unserer Datenschutzerklärung.
Einwilligung in die Verwendung von Daten zu Werbezwecken
Ich bin damit einverstanden, dass die Vogel Communications Group GmbH & Co. KG, Max-Planckstr. 7-9, 97082 Würzburg einschließlich aller mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen (im weiteren: Vogel Communications Group) meine E-Mail-Adresse für die Zusendung von redaktionellen Newslettern nutzt. Auflistungen der jeweils zugehörigen Unternehmen können hier abgerufen werden.
Der Newsletterinhalt erstreckt sich dabei auf Produkte und Dienstleistungen aller zuvor genannten Unternehmen, darunter beispielsweise Fachzeitschriften und Fachbücher, Veranstaltungen und Messen sowie veranstaltungsbezogene Produkte und Dienstleistungen, Print- und Digital-Mediaangebote und Services wie weitere (redaktionelle) Newsletter, Gewinnspiele, Lead-Kampagnen, Marktforschung im Online- und Offline-Bereich, fachspezifische Webportale und E-Learning-Angebote. Wenn auch meine persönliche Telefonnummer erhoben wurde, darf diese für die Unterbreitung von Angeboten der vorgenannten Produkte und Dienstleistungen der vorgenannten Unternehmen und Marktforschung genutzt werden.
Meine Einwilligung umfasst zudem die Verarbeitung meiner E-Mail-Adresse und Telefonnummer für den Datenabgleich zu Marketingzwecken mit ausgewählten Werbepartnern wie z.B. LinkedIN, Google und Meta. Hierfür darf die Vogel Communications Group die genannten Daten gehasht an Werbepartner übermitteln, die diese Daten dann nutzen, um feststellen zu können, ob ich ebenfalls Mitglied auf den besagten Werbepartnerportalen bin. Die Vogel Communications Group nutzt diese Funktion zu Zwecken des Retargeting (Upselling, Crossselling und Kundenbindung), der Generierung von sog. Lookalike Audiences zur Neukundengewinnung und als Ausschlussgrundlage für laufende Werbekampagnen. Weitere Informationen kann ich dem Abschnitt „Datenabgleich zu Marketingzwecken“ in der Datenschutzerklärung entnehmen.
Falls ich im Internet auf Portalen der Vogel Communications Group einschließlich deren mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen geschützte Inhalte abrufe, muss ich mich mit weiteren Daten für den Zugang zu diesen Inhalten registrieren. Im Gegenzug für diesen gebührenlosen Zugang zu redaktionellen Inhalten dürfen meine Daten im Sinne dieser Einwilligung für die hier genannten Zwecke verwendet werden. Dies gilt nicht für den Datenabgleich zu Marketingzwecken.
Recht auf Widerruf
Mir ist bewusst, dass ich diese Einwilligung jederzeit für die Zukunft widerrufen kann. Durch meinen Widerruf wird die Rechtmäßigkeit der aufgrund meiner Einwilligung bis zum Widerruf erfolgten Verarbeitung nicht berührt. Um meinen Widerruf zu erklären, kann ich als eine Möglichkeit das unter https://contact.vogel.de abrufbare Kontaktformular nutzen. Sofern ich einzelne von mir abonnierte Newsletter nicht mehr erhalten möchte, kann ich darüber hinaus auch den am Ende eines Newsletters eingebundenen Abmeldelink anklicken. Weitere Informationen zu meinem Widerrufsrecht und dessen Ausübung sowie zu den Folgen meines Widerrufs finde ich in der Datenschutzerklärung, Abschnitt Redaktionelle Newsletter.
Bild 1: Über die in CLion bereitgestellten MCP-Werkzeuge kann der KI-Agent auf Informationen aus der laufenden Debug-Session zugreifen und sie in seine Analyse einbeziehen.
(Bild: Jetbrains)
Eine zweite Schnittstelle übernimmt den Zugriff auf die Werkzeuge der IDE und stellt sie über den Model Context Protocol (MCP)-Server dem Agenten bereit. So kann er beispielsweise eine Debug-Session starten oder stoppen, Breakpoints setzen, Code schrittweise ausführen und lokale Variablen oder Stack-Frames auslesen. Hinzu kommen Speicher-, Register- und Disassembly-Zugriffe (Bild 1).
Die Aufgaben bleiben dabei klar aufgeteilt: Der Debugger liefert den realen Systemzustand, MCP macht die entsprechenden Werkzeuge für den Agenten zugänglich. Ein spezialisierter Skill strukturiert die Aufgabe, während der KI-Agent die Informationen interpretiert und entscheidet, welche Daten er für den nächsten Analyseschritt benötigt.
Vom Coding-Assistenten zur Root-Cause-Analyse
Der wesentliche Unterschied zu einem klassischen Coding-Assistenten liegt auf der Hand: Ein Agent muss nicht mehr allein aus Quellcode und Fehlermeldungen rekonstruieren, was möglicherweise passiert ist, er kann prüfen, was tatsächlich passiert.
Der KI-Agent kann hiermit beispielsweise eine verdächtige Variable identifizieren, deren aktuellen Wert auslesen, anschließend den Call Stack überprüfen und danach die Instruktionen rund um den Programmzähler analysieren. Hiermit wird die Fehlersuche zu einem iterativen Prozess, bei dem die KI gezielt weitere Informationen aus dem laufenden System abruft, um die mögliche Fehlerursache Schritt für Schritt einzugrenzen.
Die eigentliche technische Entscheidung wird hiermit nicht automatisiert, aber Entwickler müssen Registerwerte, Speicherinformationen oder Stack-Zustände nicht mehr zwangsläufig einzeln zusammensuchen und miteinander korrelieren.
Praxisbeispiel Hard Fault
Wie ein solcher Ansatz in der Praxis aussehen kann, zeigt die Analyse von Hard Faults auf Arm Cortex-M-Mikrocontrollern. Ein Hard Fault tritt auf, wenn der Prozessor einen schwerwiegenden Fehler feststellt und das Programm nicht fortsetzen kann. Ursachen können unter anderem ungültige Speicherzugriffe, Stack Overflows oder fehlerhafte Pointer sein. Für eine Diagnose müssen Entwickler Fault-Statusregister wie CFSR oder HFSR auswerten, den Stack Frame untersuchen und den Programmzähler mit dem Disassembly abgleichen.
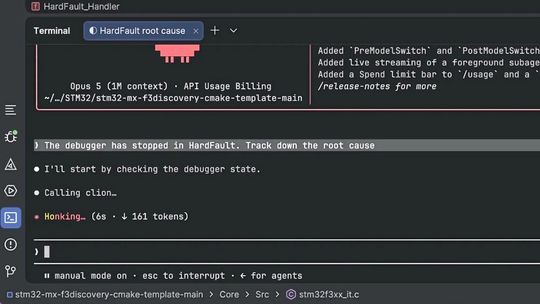
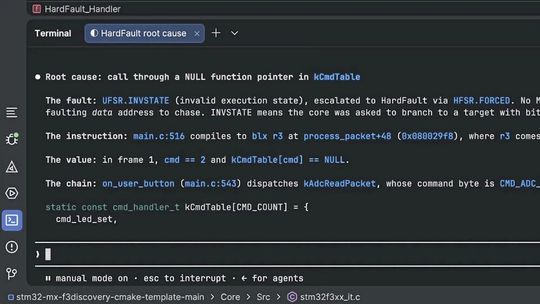
CLion 2026.2.2 automatisiert Teile des Ablaufs mit dem Skill „clion-embedded-hardfault“. Die IDE stellt dem Agenten nicht nur rohe Registerausgaben bereit, sondern bereits dekodierte Fault-Register, den gesicherten Exception Frame, Speicherinformationen, Disassembly sowie Peripherieregister.
Bild 2: Der KI-Agent verfolgt den Hard Fault anhand der realen Debugger-Daten bis zur möglichen Ursache zurück und zeigt die betroffene Codeposition sowie einen Lösungsvorschlag an.
(Bild: Jetbrains)
Ein Beispiel verdeutlicht den Ablauf: Ein falscher Byte-Offset in einem Packet Handler führt dazu, dass eine leere Position in einer Tabelle mit Funktionszeigern angesprochen wird. Das Programm versucht über die Adresse 0x00000000 zu springen und löst einen Hard Fault aus. Der Agent liest den tatsächlichen Fault-Zustand und den Call Stack aus, verfolgt den Zusammenhang bis zur fehlerhaften Codezeile zurück und stellt die Ursache verständlich dar (Bild 2). Auf Wunsch kann er anschließend den Code neu kompilieren, auf die reale Hardware flashen und in einer weiteren Debug-Session prüfen, ob der Fehler tatsächlich behoben wurde.
Integration statt zusätzlicher KI-Insel
Debugging mithilfe von KI ist grundsätzlich ebenso mit separat aufgebauten GDB-Brücken möglich. Dies bedeutet aber einen zusätzlichen Entwicklungsaufwand: Wer Agent, Debugger und Hardware selbst miteinander verbindet, muss zusätzlich eine eigene Infrastruktur für die Datenerfassung, Steuerung und Validierung entwickeln.
Der IDE-integrierte Ansatz versucht den Aufwand zu reduzieren. Debugger, Quellcode, Hardwarezugriff und KI-Agent arbeiten im selben Kontext. Gleichzeitig bleibt die vorhandene Infrastruktur nutzbar. Der Hard-Fault-Ansatz von CLion ist nicht an eine bestimmte Probe gebunden und lässt sich unter anderem mit Lauterbach TRACE32, SEGGER J-Link und STMiroelectronics ST-LINK einsetzen. Außerdem kann die IDE mit DAP-kompatiblen Debuggern über TCP kommunizieren und unterstützt sowohl Launch- als auch Attach-Szenarien. Hiermit lassen sich herstellerspezifische oder entfernte Debugging-Werkzeuge in denselben Workflow einbinden.
Gerade im Automotive-Umfeld ist die Offenheit wichtig, weil deren Toolchains häufig über Jahre gewachsen sind und unterschiedliche Debug-Probes, SDKs und Zielplattformen umfassen. Ergänzend gewinnt die Integration externer Analyseergebnisse an Bedeutung: Seit Version 2026.1.2 lassen sich beispielsweise SARIF-Berichte von Werkzeugen wie Parasoft C/C++test oder dem Clang Static Analyzer direkt in der IDE auswerten.
Der größere Hebel von KI in der Embedded-Entwicklung liegt deshalb nicht in immer schnellerem Generieren von Code, sondern im Unterstützen zeitintensiver Analyseprozesse. Ein Agent kann Debugging-Daten sammeln, Register dekodieren, Zusammenhänge herstellen und mögliche Ursachen eingrenzen. Hierdurch bleibt erfahrenen Entwicklern mehr Zeit für das Bewerten, Korrigieren und Validieren von Code.
Gerade in sicherheitskritischen Automotive-Projekten ist diese Rollenverteilung wesentlich. Ein Agent kann eine Diagnose beschleunigen und eine Codezeile verbessern. Verantwortlich dafür, welchen Code man tatsächlich ausliefert und ob die zugrunde liegende Analyse belastbar ist, bleibt jedoch das Entwicklerteam.
Genau darin liegt der entscheidende Schritt vom Coding-Assistenten zum Embedded-Debugging-Werkzeug: KI erhält Zugriff auf den realen Systemzustand, ohne die Kontrolle über das Ergebnis und die Evidenz abzugeben. Wer den Code verantwortet, bleibt selbst dann verantwortlich, wenn ein Agent einen Teil der Fehlersuche übernimmt. (sg)
* Artemy Pestretsov ist Head of the C and C++ Ecosystem bei JetBrains.