An der Rückverfolgbarkeit von Software-Artefakten führt in der modernen Softwareentwicklung kein Weg vorbei. Wer jedoch das Laufzeitverhalten einer Software verstehen will, muss auch nachvollziehen können, wie sie sich während des Betriebs verhält.
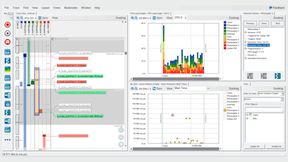
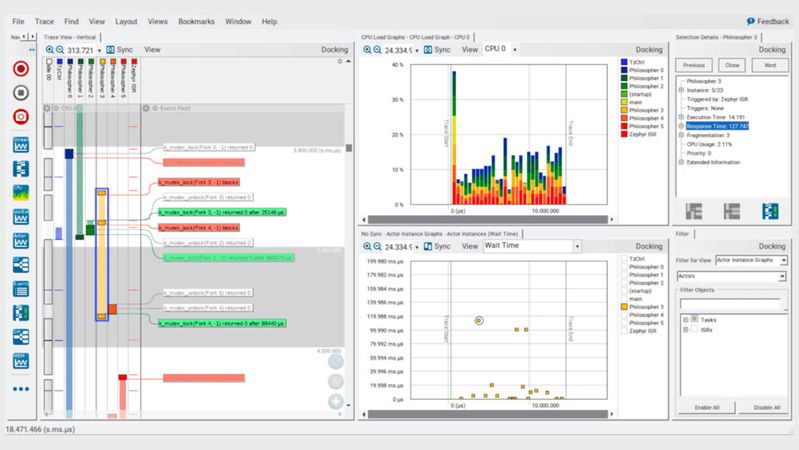
Percepio Tracealyzer visualisiert das Laufzeitverhalten und hilft Entwicklern, Task-Scheduling, Timing und Systemereignisse miteinander in Beziehung zu setzen.
(Bild: Percepio)
In der modernen Embedded-Softwareentwicklung sorgen reproduzierbare Builds dafür, dass eine bestimmte Version des Quellcodes zusammen mit einer definierten Toolchain stets dasselbe, eindeutig nachvollziehbare Firmware-Image erzeugt. Damit lässt sich der Weg vom Quellcode bis zur auf dem Zielsystem eingesetzten Software lückenlos dokumentieren.
Für viele Unternehmen bildet diese Nachvollziehbarkeit das Rückgrat ihres technischen Audit Trails. Teams können so jederzeit klären, welche Software gebaut wurde, wie sie gebaut wurde und welche Version letztlich zum Einsatz kam. Einige der schwierigsten Fragen der Softwareentwicklung stellen sich jedoch erst nach dem Deployment – wenn die Software mit realer Hardware und realen Betriebsbedingungen interagiert. Um sie beantworten zu können, muss die Rückverfolgbarkeit über das reine Software-Artefakt hinausreichen und auch Informationen über die Laufzeit liefern.
Wenn identische Firmware zu unterschiedlichen Ergebnissen führt
Embedded-Entwickler kennen Situationen, in denen sich Fehler kaum reproduzieren lassen – obwohl bei jedem Testlauf dasselbe Firmware-Image zum Einsatz kam. Ein System durchläuft beispielsweise Hunderte von Testzyklen problemlos, bevor plötzlich ein Watchdog-Reset auftritt. Ein Kommunikations-Stack bleibt erst nach vielen Betriebsstunden hängen. Oder eine sporadische Latenzspitze taucht einmal auf und ist beim nächsten Testlauf spurlos verschwunden.
Die Firmware selbst hat sich in diesen Fällen nicht verändert – verändert hat sich der Ausführungskontext. Schon kleine Unterschiede im Timing genügen, um die Abfolge der Ereignisse während der Ausführung zu verändern: etwa beim Eintreffen von Interrupts, in der Reihenfolge des Task-Schedulings, im aktuellen Hardwarezustand, bei der Verfügbarkeit von Ressourcen oder bei den Umgebungsbedingungen.
Ein Beispiel: Eine geringfügige Verzögerung an einem externen Eingang kann dazu führen, dass eine Task eine gemeinsam genutzte Ressource belegt, kurz bevor eine periodische Task aufwacht und ebenfalls darauf zugreifen will. Die daraus entstehende Konkurrenz um die Ressource kann die Latenz erheblich erhöhen – allerdings nur bei genau dieser Ereignisfolge, die in lang laufenden Tests nur selten auftritt. Ähnliche Effekte entstehen durch das Timing von Interrupts, DMA-Transfers, Netzwerkverkehr oder das Zusammenspiel einzeln betrachtet fehlerfrei arbeitender Softwarekomponenten.
Besonders bei Systemtests wird das relevant. Ein reproduzierbarer Build garantiert zwar identischen Code und dieselbe Toolchain – nicht aber, dass jeder Testlauf unter identischen Laufzeitbedingungen stattfindet. Dadurch können latente Race Conditions, Timing-Abhängigkeiten, Ressourcenkonkurrenz oder seltene Scheduling-Interaktionen in wiederholten Testläufen zu unterschiedlichen Ergebnissen führen.
Das heißt nicht, dass sich das System dem Zufall überlässt. Die eigentliche Herausforderung liegt vielmehr darin, dass die Bedingungen, die einen Fehler auslösen, oft schwer zu beobachten und noch schwerer gezielt nachzustellen sind. Tritt ein Fehler auf, reicht ein einfaches Pass/Fail-Ergebnis daher nicht aus. Entwickler müssen nachvollziehen können, wie die Software ausgeführt wurde und welche Ereignisfolge zum beobachteten Ergebnis geführt hat.
Der fehlende Teil des Audit Trails
Moderne CI/CD-Systeme erzeugen bereits einen umfangreichen Audit Trail rund um die Erstellung und Auslieferung von Software: Quellcode-Versionen, Build-Logs, Binärdateien, Ergebnisse statischer Analysen, Testberichte und Deployment-Protokolle ergeben zusammen eine gut dokumentierte, nachvollziehbare Historie.
Was häufig fehlt, ist eine vergleichbare Transparenz über die Laufzeit selbst. Tritt ein Fehler auf Systemebene auf, lässt sich in der Regel exakt feststellen, welches Firmware-Image auf dem System lief – nicht aber zwangsläufig, welche Ereignisfolge zu dem Fehler geführt hat. Bei sporadischen, timingabhängigen Fehlern bleibt Entwicklern daher oft nichts anderes übrig, als aus unvollständigen Informationen Hypothesen abzuleiten, nachträglich zusätzliche Instrumentierung einzubauen und Tests so lange zu wiederholen, bis der Fehler hoffentlich erneut auftritt.
Stand: 08.12.2025
Es ist für uns eine Selbstverständlichkeit, dass wir verantwortungsvoll mit Ihren personenbezogenen Daten umgehen. Sofern wir personenbezogene Daten von Ihnen erheben, verarbeiten wir diese unter Beachtung der geltenden Datenschutzvorschriften. Detaillierte Informationen finden Sie in unserer Datenschutzerklärung.
Einwilligung in die Verwendung von Daten zu Werbezwecken
Ich bin damit einverstanden, dass die Vogel Communications Group GmbH & Co. KG, Max-Planckstr. 7-9, 97082 Würzburg einschließlich aller mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen (im weiteren: Vogel Communications Group) meine E-Mail-Adresse für die Zusendung von redaktionellen Newslettern nutzt. Auflistungen der jeweils zugehörigen Unternehmen können hier abgerufen werden.
Der Newsletterinhalt erstreckt sich dabei auf Produkte und Dienstleistungen aller zuvor genannten Unternehmen, darunter beispielsweise Fachzeitschriften und Fachbücher, Veranstaltungen und Messen sowie veranstaltungsbezogene Produkte und Dienstleistungen, Print- und Digital-Mediaangebote und Services wie weitere (redaktionelle) Newsletter, Gewinnspiele, Lead-Kampagnen, Marktforschung im Online- und Offline-Bereich, fachspezifische Webportale und E-Learning-Angebote. Wenn auch meine persönliche Telefonnummer erhoben wurde, darf diese für die Unterbreitung von Angeboten der vorgenannten Produkte und Dienstleistungen der vorgenannten Unternehmen und Marktforschung genutzt werden.
Meine Einwilligung umfasst zudem die Verarbeitung meiner E-Mail-Adresse und Telefonnummer für den Datenabgleich zu Marketingzwecken mit ausgewählten Werbepartnern wie z.B. LinkedIN, Google und Meta. Hierfür darf die Vogel Communications Group die genannten Daten gehasht an Werbepartner übermitteln, die diese Daten dann nutzen, um feststellen zu können, ob ich ebenfalls Mitglied auf den besagten Werbepartnerportalen bin. Die Vogel Communications Group nutzt diese Funktion zu Zwecken des Retargeting (Upselling, Crossselling und Kundenbindung), der Generierung von sog. Lookalike Audiences zur Neukundengewinnung und als Ausschlussgrundlage für laufende Werbekampagnen. Weitere Informationen kann ich dem Abschnitt „Datenabgleich zu Marketingzwecken“ in der Datenschutzerklärung entnehmen.
Falls ich im Internet auf Portalen der Vogel Communications Group einschließlich deren mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen geschützte Inhalte abrufe, muss ich mich mit weiteren Daten für den Zugang zu diesen Inhalten registrieren. Im Gegenzug für diesen gebührenlosen Zugang zu redaktionellen Inhalten dürfen meine Daten im Sinne dieser Einwilligung für die hier genannten Zwecke verwendet werden. Dies gilt nicht für den Datenabgleich zu Marketingzwecken.
Recht auf Widerruf
Mir ist bewusst, dass ich diese Einwilligung jederzeit für die Zukunft widerrufen kann. Durch meinen Widerruf wird die Rechtmäßigkeit der aufgrund meiner Einwilligung bis zum Widerruf erfolgten Verarbeitung nicht berührt. Um meinen Widerruf zu erklären, kann ich als eine Möglichkeit das unter https://contact.vogel.de abrufbare Kontaktformular nutzen. Sofern ich einzelne von mir abonnierte Newsletter nicht mehr erhalten möchte, kann ich darüber hinaus auch den am Ende eines Newsletters eingebundenen Abmeldelink anklicken. Weitere Informationen zu meinem Widerrufsrecht und dessen Ausübung sowie zu den Folgen meines Widerrufs finde ich in der Datenschutzerklärung, Abschnitt Redaktionelle Newsletter.
Continuous Observability erweitert den Audit Trail um genau diese Laufzeitdimension. Observability sollte dabei nicht nur als Debugging-Methode verstanden werden, sondern als kontinuierliche Fähigkeit, während Entwicklung, Integration, Test und Validierung Daten über die reale Softwareausführung zu erfassen. Runtime Traces, Scheduling-Aktivitäten, Timing-Informationen, Ressourcennutzung, Kommunikationsereignisse und Zustandsänderungen des Systems zeigen konkret, wie sich die Software während des Betriebs verhalten hat.
Dieser zusätzliche Kontext wird umso wertvoller, je komplexer Embedded-Systeme werden. Fehler entstehen selten durch eine einzelne fehlerhafte Codezeile, sondern meist durch das Zusammenspiel von Tasks, Interrupts, Middleware, Treibern und Hardwarekomponenten. Mit Einblick in die Ausführungshistorie ist ein Watchdog-Reset dann nicht mehr nur das letzte Glied einer Fehlerkette: Entwickler können untersuchen, ob sich die Latenz einer Task schrittweise erhöht hat, ob die Ressourcenkonkurrenz unerwartet zugenommen hat, ob sich die CPU-Auslastung verändert hat oder ob eine bestimmte Ereignisfolge den Fehler ausgelöst hat. Statt einen unbekannten Zustand mühsam nachstellen zu müssen, können sie einen konkret aufgezeichneten Ablauf analysieren.
Reproduzierbarkeit und Observability ergänzen sich
Reproduzierbare Builds und Runtime Observability decken unterschiedliche Aspekte der Rückverfolgbarkeit ab. Reproduzierbare Builds schaffen Vertrauen in das Software-Artefakt selbst: Sie stellen sicher, dass ein definierter Quellcode-Stand zusammen mit einer definierten Toolchain ein überprüfbares Firmware-Image erzeugt, und verbinden so entwickelte, getestete und letztlich deployte Software miteinander. Observability wiederum schafft Vertrauen in das Verhalten dieses Artefakts während der Ausführung. Sie hilft Entwicklern, zeitliche Zusammenhänge, Scheduling-Effekte, Muster bei der Ressourcennutzung und Interaktionen auf Systemebene zu verstehen – Zusammenhänge, die in klassischen Build- und Testprotokollen nicht sichtbar sind.
Die eine Disziplin beantwortet die Frage: „Welche Software lief auf dem System?“ Die andere beantwortet: „Was ist passiert, während sie lief?“ Damit entsteht eine wesentlich umfassendere Grundlage, um Fehler zu diagnostizieren, das Systemverhalten zu validieren und die Zuverlässigkeit zunehmend komplexer Embedded-Systeme sicherzustellen.
Der nächste Schritt: CI, CT und CO
Mit zunehmender Komplexität von Embedded-Software lohnt sich der Blick über CI/CD hinaus. Während Continuous Integration (CI) für die konsistente Integration und den zuverlässigen Build der Software sorgt, prüft Continuous Testing (CT), ob sich das System unter definierten Bedingungen erwartungsgemäß verhält. Continuous Observability (CO) ergänzt beides um Transparenz darüber, wie sich das System im laufenden Betrieb verhält.
Diese drei Fähigkeiten greifen ineinander. Reproduzierbare Builds bleiben dabei ein zentraler Baustein für Integrität und Rückverfolgbarkeit der eingesetzten Software. Observability ergänzt diese Grundlage um die Laufzeitdaten, die nötig sind, um komplexes Systemverhalten zu verstehen, die Wiederholbarkein von Systemtests und Validierungen zu verbessern und bei Fehlern schneller zur Ursache vorzudringen.
Die nächste Entwicklungsstufe von Embedded DevOps liegt damit nicht allein in CI/CD, sondern im Zusammenspiel von CI, CT und CO. So lässt sich der Audit Trail über den gesamten Softwarelebenszyklus erweitern – von der Frage, welche Software gebaut und ausgeliefert wurde, bis hin zur Frage, wie sie sich im Betrieb tatsächlich verhalten hat. (sg)
* Dr. Johan Kraft ist CTO und Gründer von Percepio.